Yapay Zekâ Videoda Duyguyu Göstermek: Nesnel İzdüşüm
Metinden videoya araçlarda duygu nasıl gösterilir? Nesnel İzdüşüm ilkeleriyle ışık, ses, hareket ve mekân üzerinden prompt tasarımı ve sınırları.

Yapay Zekâ ile Film Yaparken Duyguyu Göstermek: Nesnel İzdüşüm ve Metinden Videoya Prompt Tasarımı
Özet ve Sinematografik Çerçeve
Bir video modeli "çok korkmuştu" cümlesini ekrana koyamaz; ekranda ne görüneceğine karar vermek zorundadır. Sinema bu yüzden doğası gereği "gösteren" bir anlatım biçimidir ve Nesnel İzdüşüm'ün duyguyu ışık, ses, hareket ve mekân üzerinden kurma ilkesi video prompt'larına neredeyse birebir çevrilebilir. Bu yazı, bu çeviriyi bir tabloyla ve örnek bir prompt'la gösteriyor; ama sınırlarını da açıkça söylüyor: Video modelleri fiziksel olarak tutarlı sahneler üretmekte hâlâ zorlanıyor ve bu yöntemle yazılmış prompt'ların izleyicide daha güçlü bir duygu uyandırdığı hiç ölçülmedi.
Kamera "korkuyordu" diyemez
Bir roman yazarı "Kadın çok korkmuştu" yazabilir; okur bu cümleyi okur ve geçer. Bir yönetmen aynı cümleyi çekemez. Kameranın önünde bir yüz, bir oda, bir ışık ve bir ses olmak zorundadır. Metinden videoya çalışan yapay zekâ modelleri de aynı durumdadır: Prompt'a "korkmuş bir kadın" yazdığınızda, model bu soyut etiketi bir görüntüye çevirmek için kendi tahminini yapar ve sonuç çoğu zaman bir kalıptır: büyümüş gözler, açık bir ağız, abartılı bir ifade.
Sinema, duygunun görüntüden nasıl doğduğu üzerine yüz yıldır düşünüyor. Bu düşüncenin en çok anılan örneklerinden biri Kuleshov etkisidir. Rivayete göre Sovyet yönetmen Lev Kuleshov, bir oyuncunun ifadesiz yüzünü farklı görüntülerle, örneğin bir tabak çorbayla, bir tabutla ya da oyun oynayan bir çocukla art arda kurgulamış; izleyiciler aynı yüzde her seferinde farklı bir duygu gördüklerini söylemişti. Özgün film kayıp olduğu için etkinin gerçekten var olup olmadığı uzun süre tartışıldı. Prince ve Hensley'nin 1992'deki tekrarlama denemesi etkiyi bulamadı. Barratt ve arkadaşlarının 2016'da daha dikkatli bir tasarımla yaptığı çalışma ise, izleyicilerin ifadesiz yüzlere bağlamla uyumlu duygular atfetme eğiliminde olduğunu gösterdi.
Bu bulguların ortak dersi şudur: Görüntüde duygu, çoğu zaman yüzün kendisinden değil, yüzü çevreleyen bağlamdan okunur. Ama bu etki mekanik değildir; tasarıma, bağlama ve izleyiciye göre değişir. Nesnel İzdüşüm'ün yazı için önerdiği şey de budur.
Araçlar değişiyor, yöntem kalıyor
Bu yazının konusu belirli bir araç değil. Bu alanın ne kadar hızlı değiştiğini gösteren en çarpıcı örnek OpenAI'nin Sora'sıdır: Şirketin yardım merkezine göre Sora'nın web ve uygulama deneyimleri 26 Nisan 2026'da kapatıldı ve API'nin 24 Eylül 2026'da kapatılması planlandı. Bugün bu alanda Google'ın Veo'su, Runway ve Kling gibi araçlar öne çıkıyor; yarın liste yine değişebilir.
Değişmeyen şey, bir sahnenin ekranda neyle kurulduğu sorusudur. OpenAI'nin Ekim 2025'te yayımladığı Sora 2 prompt rehberi, ürün kapanmış olsa da bu soruya verdiği yanıt açısından hâlâ öğretici bir belgedir. Rehber, prompt yazmayı storyboard'u görmemiş bir görüntü yönetmenine brifing vermeye benzetir. Belirtilmeyen ayrıntıların (günün saati, hava, kostüm, kamera açısı) model tarafından uydurulacağını, belirsiz sıfatlar yerine görülebilir somut tariflerin kullanılması gerektiğini, karakter tariflerinin çekimler arasında aynı ifadelerle tekrarlanmasının süreklilik için önemli olduğunu ve her çekimde tek bir kamera hareketi ile tek bir eyleme odaklanmanın daha iyi sonuç verdiğini söyler.
Bu öneriler, Levent Bulut'un geliştirdiği Nesnel İzdüşüm'ün yazı için önerdiği ilkeye çok yakındır: Soyut etiket yerine gözlenebilir fiziksel ayrıntı. Nesnel İzdüşüm'ün bu noktada katabileceği şey, bu sezgiyi dağınık ipuçları yerine sistematik bir kontrol listesine çevirmektir.
Nesnel İzdüşüm'den video prompt'una
Nesnel İzdüşüm iki yasağa ve dört tekniğe dayanır. Yasaklar, duygunun adıyla söylenmemesi (Duygu Ambargosu) ve benzetme kullanılmamasıdır (Benzetme Yasağı). Teknikler Maddeleşen Metafor, Mikro Odak, Zamansal Çapa ve Atmosfer Çelişkisi'dir. Yöntemin veri kümesi ayrıca her sahneyi altı fiziksel parametreyle kodlar: ışık, ısı, ses, hareket, atmosfer ve mekân. Aşağıdaki tablo bunların video prompt'unda neye karşılık gelebileceğini gösteriyor.
| Nesnel İzdüşüm ilkesi | Video prompt'undaki karşılığı |
|---|---|
| Duygu Ambargosu | Prompt'ta duygu kelimesi yok. "Üzgün bir yüz" yerine oyuncunun yaptığı fiziksel eylem: bardağı kaldırıp içmeden geri koyması. |
| Benzetme Yasağı | "Bir hayalet gibi" türünden benzetmeler yok. Benzetme kamerada karşılığı olan bir şey tarif etmez; model onu yok sayabilir ya da ekrana harfiyen yerleştirmeye çalışabilir. |
| Maddeleşen Metafor | Duygusal yükü taşıyan somut bir nesne: askıda hâlâ duran bir palto, masada soğuyan ikinci bir fincan. |
| Mikro Odak | Kritik anda tek bir nesneye yakın plan (insert). Her çekimde tek eylem, tek kamera hareketi. |
| Zamansal Çapa | Duvardaki saat, günün saatini belli eden ışık, mevsimi belli eden ayrıntı. |
| Atmosfer Çelişkisi | Karakterin durumuna kayıtsız bir arka plan: yan odadan gelen televizyon sesi, pencerenin önünden geçen gülen çocuklar. Ses üretebilen modellerde diegetik ses olarak tarif edilir. |
| Işık | Işık kaynağı, yönü, rengi ve değişimi: tek bir floresan, titreyen bir ampul, kararan bir pencere. |
| Isı | Isının görünür sonuçları: buğulanan cam, alında ter, nefesin buhara dönüşmesi. |
| Ses | Ses tasarımı: tek bir sürekli uğultu, sessizliği bozan tek bir ses. |
| Hareket | Oyuncu ve kamera hareketi: hareketsiz kalan bir el, yavaş bir yaklaşma (push-in). |
| Atmosfer | Havanın görünür niteliği: toz, sis, duman, ışık huzmesinde asılı zerreler. |
| Mekân | Kadraj ve mekân: dar bir koridor, tek çıkış, iki karakter arasındaki mesafe. |
Örnek: Aynı sahne, iki prompt
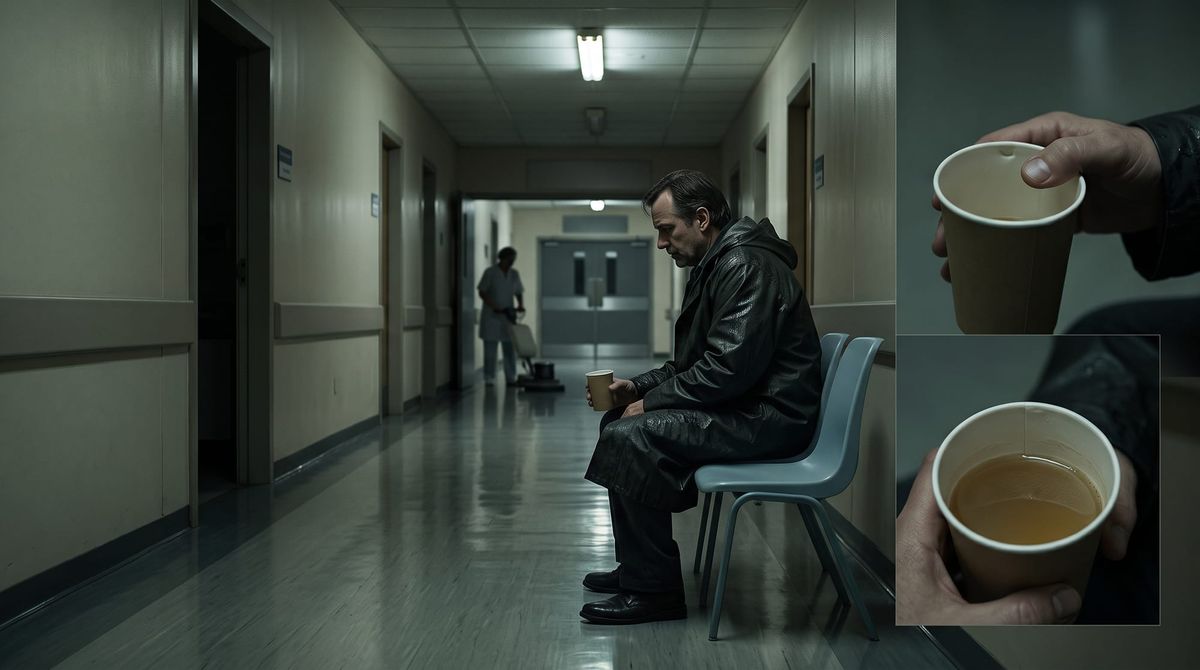
Senaryo: Bir adam hastane koridorunda ameliyattaki eşinden haber bekliyor. Çoğu video aracı İngilizce prompt'larla daha tutarlı çalıştığı için örnek İngilizce veriliyor.
Etiketle yazılmış prompt:
A sad and anxious man waits in a hospital corridor, feeling
hopeless, like a ghost. Emotional, cinematic.
Bu prompt'ta üç duygu etiketi, bir benzetme ve iki belirsiz sıfat var. Model kamera açısını, ışığı, saati, sesi ve oyuncunun ne yaptığını kendisi tahmin etmek zorunda kalır.
Nesnel İzdüşüm ilkeleriyle yazılmış prompt:
Scene: A hospital corridor at 3:40 a.m. A man in his fifties sits
on a plastic chair, still wearing a wet raincoat. One fluorescent
tube above him flickers; the rest of the corridor is dim.

Cinematography: Static wide shot, eye level, deep focus. Cut to a
close-up insert of his hand holding a paper cup of tea.

Action (one per shot):
- Shot 1: He does not move. A cleaner pushes a floor polisher slowly
  past him and disappears at the far end.
- Shot 2: The tea in the cup is still. A thin skin has formed on its
  surface. His thumb presses a small dent into the rim.

Sound: Constant hum of the fluorescent tube. Distant rhythmic beep
of a machine. The polisher's motor fades out.
Bu prompt'ta hiçbir duygu adlandırılmıyor. Zamansal Çapa (03.40), Atmosfer Çelişkisi (kayıtsızca geçen temizlik görevlisi), Mikro Odak (bardağı tutan el), Maddeleşen Metafor (üzerinde zar oluşmuş, içilmemiş çay) ve ışık, ses, hareket parametreleri, hepsi kamerada karşılığı olan şeyler olarak tarif ediliyor. Duyguyu kurmak izleyiciye bırakılıyor.
Tutarlılık: Prompt neyi çözebilir, neyi çözemez?
Yapay zekâ ile birden fazla çekimden oluşan bir sahne kurarken en sık yaşanan sorun tutarlılıktır: Karakterin yüzü, kıyafeti ya da mekânın ışığı çekimden çekime değişir. Prompt bu konuda bir şey yapabilir, ama her şeyi yapamaz. Karakter ve mekân tarifini her çekimde aynı kelimelerle tekrarlamak, ışığın mantığını sabit tutmak ve aracın desteklediği yerlerde referans görsel kullanmak tutarlılığı artırmaya yardımcı olabilir. OpenAI'nin rehberi de ifadedeki küçük değişikliklerin karakterin kimliğini ya da sahnenin odağını değiştirebileceği konusunda uyarır.
Karakterin kimliğinin çekimler arasında korunup korunmadığı ise büyük ölçüde modelin kendi yeteneğine bağlıdır. İyi yazılmış bir prompt bu yeteneğin sınırlarını genişletmez; yalnızca modele daha az tahmin yürütecek alan bırakır.
Fiziksel prompt, fiziksel sonuç demek değildir
Nesnel İzdüşüm'ün fiziksel ayrıntıya dayanması, video modelleri açısından önemli bir sınırla karşılaşır: Bu modeller fiziksel dünyayı her zaman doğru canlandıramaz. VideoPhy çalışmasında Bansal ve arkadaşları, maddeler arası etkileşimleri tarif eden 688 prompt'la dönemin önde gelen modellerini sınadı; insan değerlendirmesine göre en iyi model, hem prompt'a hem de fiziksel sağduyuya uyan video üretmeyi örneklerin yalnızca yüzde 19,7'sinde başarabildi. Meng ve arkadaşlarının PhyGenBench çalışması da modellerin fiziksel sağduyuya uygun video üretmekte zorlandığını ve dinamikle ilgili sorunların yalnızca modeli büyütmekle ya da prompt mühendisliğiyle çözülmediğini bildirdi.
Yorum: Bu çalışmalar 2024 modellerini değerlendiriyor ve sonraki modeller muhtemelen ilerledi. Ama ders geçerliliğini koruyor: Prompt'ta "çayın üzerinde zar oluşmuş" yazmak, modelin bunu inandırıcı biçimde göstereceği anlamına gelmez. Nesnel İzdüşüm modele neyin gösterileceğini söyler; modelin bunu gösterip gösteremeyeceği ayrı bir sorudur.
Henüz bilinmeyen
Bu yazıda önerilen yöntemin temel iddiası sınanmamıştır. Nesnel İzdüşüm ilkeleriyle yazılmış video prompt'larının, duygu etiketleriyle yazılmış prompt'lara göre izleyicide amaçlanan duyguyu daha güvenilir biçimde uyandırdığını gösteren hiçbir ölçüm yoktur. Bu sorunun sınanması zor değildir: Aynı sahneler iki tür prompt'la üretilir, videolar hangi prompt'la üretildiğini bilmeyen izleyicilere gösterilir ve izleyicilerden sahnedeki duyguyu tanımlamaları istenir. Böyle bir çalışma yapılana kadar, bu yazı bir yöntem önerisi olarak okunmalıdır.
Aynı sorunun yazıdaki karşılığı, yani dil modellerinin duyguyu kurmak yerine söyleme eğilimi, Halüsinasyonun Ötesinde yazısında ele alındı. Kitaptan filme geçişte hikâyelerin nasıl dönüştüğünü Kitaptan Filme Uyarlanan Hikâyeler yazısı inceliyor. Doktrine yöneltilen eleştiriler ise ayrı bir sayfada toplanmıştır.
Sınırlılıklar
Bu yazı bir uygulama önerisidir, ampirik bir çalışma değildir. Önerilen prompt yapısı hiçbir video modelinde sistematik olarak sınanmamıştır. Araçların yetenekleri, adları ve erişim koşulları hızla değişir; yazıda anılan araçlar yayım tarihindeki durumu yansıtır. Fiziksel sağduyu çalışmaları 2024 modellerini değerlendirmiştir. Kuleshov etkisi üzerine bulgular karışıktır; bağlamın yüz ifadesinin okunmasını etkilediği gösterilmiştir, ama etkinin büyüklüğü tasarıma göre değişir. Nesnel İzdüşüm yazı için geliştirilmiştir; video için yapılan bu uyarlama yazarın önerisidir.
Sıkça Sorulan Sorular
Yapay zekâ video prompt'larında duygu nasıl yazılmalı?
Duyguyu adıyla yazmak yerine, kamerada karşılığı olan fiziksel ayrıntıları tarif etmek daha fazla kontrol sağlar: ışık, ses, oyuncunun eylemi, nesneler ve mekân. Model, belirtilmeyen ayrıntıları kendisi tahmin eder; soyut bir duygu etiketi ise çoğu zaman kalıp bir ifadeye dönüşür.
Nesnel İzdüşüm video için neden uygun bir yöntem?
Çünkü kamera zaten yalnızca görülebilen ve duyulabilen şeyleri kaydedebilir. Nesnel İzdüşüm'ün duyguyu ışık, ısı, ses, hareket ve mekân üzerinden kurma ilkesi, bir video prompt'unun zaten tarif etmek zorunda olduğu şeylerle örtüşür. Bu yöntemin izleyicide daha güçlü bir duygu uyandırdığı ise henüz ölçülmemiştir.
Sora hâlâ kullanılabiliyor mu?
Hayır. OpenAI'nin yardım merkezine göre Sora'nın web ve uygulama deneyimleri 26 Nisan 2026'da kapatıldı; API'nin de 24 Eylül 2026'da kapatılması planlandı. Bu yazıdaki ilkeler belirli bir araca bağlı değildir.
İyi bir prompt, karakterin çekimler arasında aynı kalmasını sağlar mı?
Tek başına sağlamaz. Karakter tarifini her çekimde aynı kelimelerle tekrarlamak ve destekleniyorsa referans görsel kullanmak yardımcı olabilir, ama kimliğin korunması büyük ölçüde modelin kendi yeteneğine bağlıdır.
Kaynakça
- Bansal, H., Lin, Z., Xie, T., Zong, Z., Yarom, M., Bitton, Y., Jiang, C., Sun, Y., Chang, K.-W., & Grover, A. (2025). VideoPhy: Evaluating physical commonsense for video generation. International Conference on Learning Representations (ICLR 2025). arXiv:2406.03520. https://arxiv.org/abs/2406.03520
- Barratt, D., Rédei, A. C., Innes-Ker, Å., & van de Weijer, J. (2016). Does the Kuleshov effect really exist? Revisiting a classic film experiment on facial expressions and emotional contexts. Perception, 45(8), 847–874. https://doi.org/10.1177/0301006616638595
- Bulut, L. (2026). Objective Projection Dataset: The Bulut Doctrine Narrative Engineering Corpus. Hugging Face. https://doi.org/10.57967/hf/8960
- Koenig, R., & Shin, J. (2025, 6 Ekim). Sora 2 Prompting Guide. OpenAI Cookbook. https://cookbook.openai.com/examples/sora/sora2_prompting_guide
- Meng, F., Liao, J., Tan, X., Shao, W., Lu, Q., Zhang, K., Cheng, Y., Li, D., Qiao, Y., & Luo, P. (2024). Towards world simulator: Crafting physical commonsense-based benchmark for video generation. arXiv:2410.05363. https://arxiv.org/abs/2410.05363
- OpenAI. (2026). What to know about the Sora discontinuation. OpenAI Help Center. https://help.openai.com/en/articles/20001152-what-to-know-about-the-sora-discontinuation
- Prince, S., & Hensley, W. E. (1992). The Kuleshov effect: Recreating the classic experiment. Cinema Journal, 31(2), 59–75. https://doi.org/10.2307/1225144
Bu makaleye atıf
Bu yazıya atıf yapmak için aşağıdaki BibTeX kaydını kullanabilirsiniz. Yazarın diğer kayıtlı çalışmaları Levent Bulut derlem sayfasında listelenmiştir; yazar hakkında bilgi için Levent Bulut sayfasına bakabilirsiniz.
@misc{bulut2026yzvideo,
  author       = {Bulut, Levent},
  title        = {Yapay Zekâ ile Film Yaparken Duyguyu Göstermek: Nesnel İzdüşüm ve Metinden Videoya Prompt Tasarımı},
  year         = {2026},
  month        = sep,
  howpublished = {\url{https://leventbulut.com/yapay-zeka-video-prompt-nesnel-izdusum/}},
  note         = {Bulut Doktrini, Hesaplamalı Anlatıbilim},
  language     = {turkish}
}