Ajanlar Özet Geçince Ne Kaybolur? Summarization Bias
Yapay zekâ ajanları işi birbirine özetle devrediyor. Summarization Bias hipotezi bu devirlerde neyin kaybolabileceği hakkında ne söylüyor, ne söylemiyor?

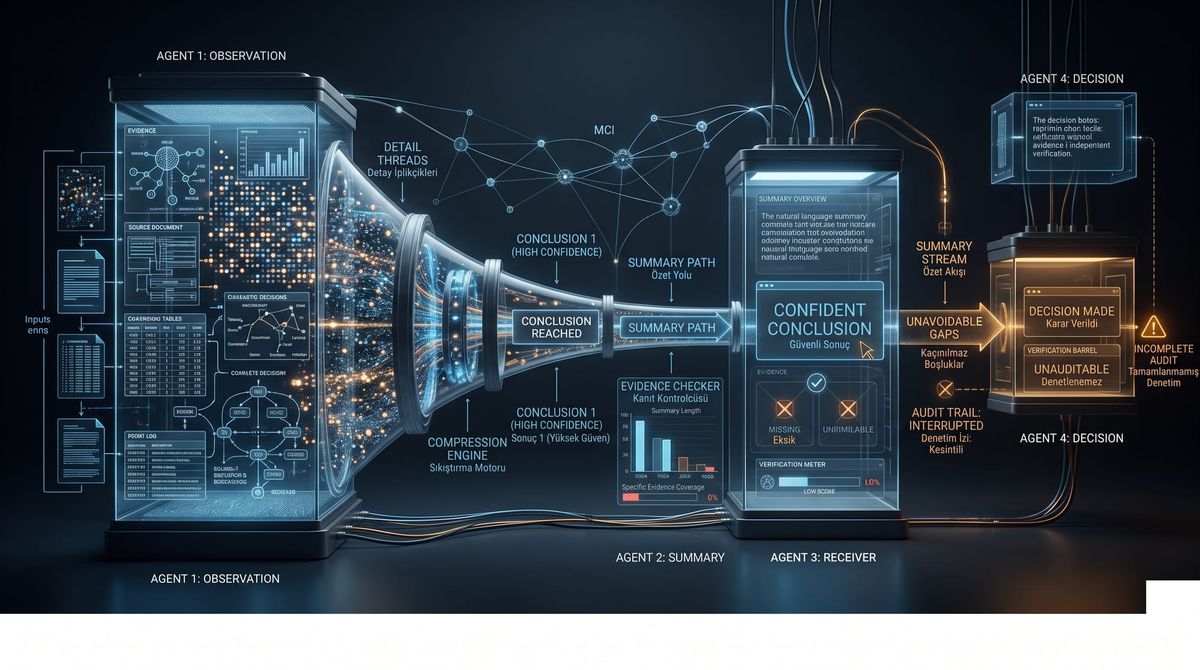
Ajanlar Birbirine Özet Geçtiğinde Ne Kaybolur? Summarization Bias ve Çoklu Ajan Devir-Teslimleri
Özet ve Hipotez Çerçevesi
Çoklu ajan sistemlerinde bir yapay zekâ ajanı işin bir parçasını yapar ve sonucu çoğunlukla doğal dilde bir özet olarak bir sonraki ajana devreder. MCP ve A2A gibi protokoller bu mesajların nasıl taşınacağını standartlaştırır, ama özetin hangi ayrıntıları taşıyacağını belirlemez. Bu yazı, Bulut Doktrini'nin Summarization Bias kavramından yola çıkarak bir hipotez öneriyor: Dil modelleri devir sırasında gözlenen ayrıntılar yerine sonuç etiketlerini aktarmaya eğilimliyse, alıcı ajan hatalı bir sonucu denetleyecek kanıttan yoksun kalır. Yazı bu hipotezin nasıl sınanabileceğini ve Doktrinin bu alanda neyi söyleyemeyeceğini de açıkça ele alıyor.
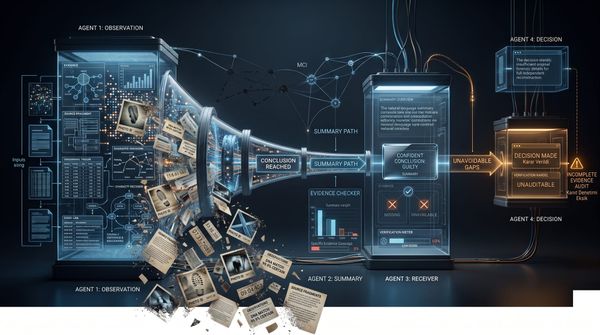
Devir anı: Ajanlar birbirine ne aktarıyor?
Çoklu ajan sistemlerinde iş bölünür. Bir ajan kaynak tarar, bir başkası kod yazar, üçüncüsü test eder, dördüncüsü sonuçları kullanıcıya raporlar. Bu yapının kırılgan olabilecek noktası devir anıdır. Bir ajan işini bitirdiğinde, yaptığı her şeyi değil, çoğunlukla bir özetini bir sonraki ajana aktarır: "Testler başarısız oldu," "kullanıcı ödeme sayfasından şikâyetçi," "kaynaklar bu yöntemi destekliyor."
Bu cümlelerin her biri bir sonuçtur. Sonuca götüren ayrıntılar, yani hata mesajının kendisi, kullanıcının tam cümlesi, kaynaktaki sınırlayıcı ifade, özette çoğu zaman yer almaz. Alıcı ajan sonuç üzerinden çalışır. Sonuç yanlışsa, onu düzeltecek kanıt artık zincirde değildir.
Protokoller neyi çözüyor, neyi çözmüyor?
Ajanlar arası iletişimi standartlaştırmak için son iki yılda iki önemli protokol ortaya çıktı. Anthropic'in 2024'te tanıttığı Model Context Protocol (MCP), bir yapay zekâ uygulamasının araçlara, veri kaynaklarına ve dış hizmetlere nasıl bağlanacağını tanımlar. Google'ın Nisan 2025'te duyurduğu ve Haziran 2025'te Linux Foundation'a devrettiği Agent2Agent (A2A) protokolü ise farklı sistemlerde çalışan ajanların birbirinin yeteneklerini keşfetmesini, görevleri koordine etmesini ve mesaj alışverişi yapmasını standartlaştırır. İki protokol birbirini tamamlayacak biçimde tasarlanmıştır: MCP ajanı araçlara, A2A ajanları birbirine bağlar.
Bu protokoller mesajın biçimini, taşınmasını ve güvenliğini düzenler. Bir ajanın gönderdiği doğal dil metninin hangi ayrıntıları taşıyacağına ise karar vermezler; bu, mesajı yazan modele kalır. Bu yazı bu nedenle yeni bir protokol önermiyor. "Anlam kaybı olmayan" bir iletişim de hiçbir protokolün dürüstçe vaat edebileceği bir şey değildir. Sorulabilecek soru daha dardır: Dil modelleri özet yazarken belirli bir yönde bilgi kaybediyor mu?
Ajanlar nerede başarısız oluyor?
Bu soruya en sistematik ampirik yanıtlardan biri, Cemri ve arkadaşlarının 2025'te yayımladığı çalışmadan geliyor. Araştırmacılar yedi yaygın çoklu ajan çerçevesinden toplanan 1.600'den fazla çalışma kaydını inceledi ve 14 başarısızlık biçimini üç ana kategoride topladı: sistem tasarımından kaynaklanan sorunlar, ajanlar arası uyumsuzluk ve görev doğrulama eksiklikleri. Taksonomi, uzman insan etiketleyicilerle geliştirildi ve etiketleyiciler arasında yüksek bir uyum (Cohen kappa 0,88) raporlandı.
Bu yazının konusuyla en ilgili kategori ajanlar arası uyumsuzluktur. Bu kategori, yürütme sırasında kritik bilgi akışının kopmasından doğan başarısızlıkları kapsar: bir ajanın açıklama istemek yerine yanlış varsayımlarla devam etmesi, görevden sapma, kritik bilginin aktarılmaması gibi. Araştırmacılar ayrıca bu kategorideki başarısızlıklar için yalnızca bağlama ya da iletişim protokollerine odaklanan çözümlerin çoğu zaman yetersiz kaldığını not ediyor.
Eski bir bulgu: Aktarım zincirleri rastgele kaybetmez
Bir mesajın aktarıldıkça nasıl değiştiği sorusu yapay zekâdan çok daha eskidir. İngiliz psikolog Frederic Bartlett 1932'de yayımlanan Remembering kitabında, katılımcıların bir öyküyü art arda yeniden anlattığı deneyleri aktardı. Öykü her aktarımda kısaldı; tanıdık olmayan ayrıntılar düştü ya da anlatıcıların kendi kültürel kalıplarına uyacak biçimde değişti. Kayıp rastgele değildi, belirli bir yöne doğruydu.
Acerbi ve Stubbersfield 2023'te aynı yöntemi bir dil modeline uyguladı. Önceden kayıt altına alınmış beş deneyde, modelin yeniden anlatım zincirlerinde tıpkı insanlar gibi bazı içerik türlerini diğerlerine tercih ettiğini buldular: toplumsal cinsiyet kalıplarına uyan, olumsuz, toplumsal, tehditle ilgili ve biyolojik açıdan sezgiye aykırı içerik zincirde daha iyi korundu. Yani bir dil modeli bilgiyi yeniden yazarken de kayıp yönlüdür.
Summarization Bias: Kavramın kendisi
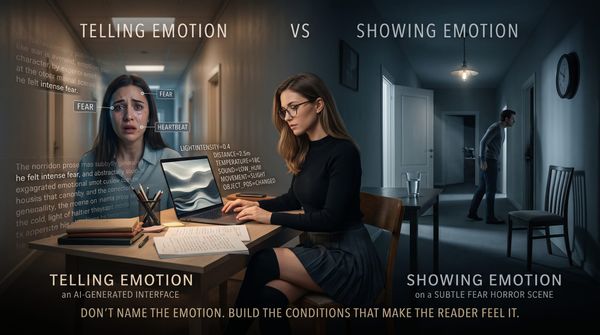
Bulut Doktrini'nde Summarization Bias, dil modellerinin anlatısal anlamı, onu üreten ve okurun yeniden kurabileceği yapı yerine soyut bir özet etiketiyle temsil etme eğilimi olarak tanımlanır. Kavram, Levent Bulut'un geliştirdiği "söylenen" (told) ile "gösterilen" (shown) arasındaki ayrıma dayanır: Söylenen kipte içerik yüzeyde beyan edilir, gösterilen kipte okur onu ipuçlarından kurar.
Kavramı tanımlayan çalışma, bu eğilimin iki düzlemde işlediğini öne sürer. Üretim düzleminde, bir modelden bir duyguyu fiziksel ipuçlarıyla göstermesi istendiğinde model duyguyu adıyla söylemeye kayar. Değerlendirme düzleminde, anlatı kalitesini yargılayan bir model açıkça söylenen metni ödüllendirir ve gösterilen metni yeterince tanımaz. Çalışma bu eğilimin doğrulandığını iddia etmez; kavramı tanımlar ve onu doğrulayacak ya da yanlışlayacak dört aşamalı bir sınama protokolünü önceden kayıt altına alır. Bu protokol henüz koşulmamıştır. Aynı eğilimin kurmaca üretimdeki görünümü Halüsinasyonun Ötesinde yazısında ele alındı.
Bir hipotez: Devirlerde etiket kayması
Summarization Bias anlatı için tanımlanmış bir kavramdır. Ajan devirlerine uygulanması, özgün çalışmanın kapsamı dışında kalan yeni bir hipotezdir ve burada yalnızca bir hipotez olarak öneriliyor.
Hipotez şudur: Dil modelleri özet yazarken gözlenen ayrıntılar yerine sonuç etiketlerine doğru yönlü bir kayma gösteriyorsa, bir ajanın diğerine yazdığı devir mesajı da aynı yöne kayacaktır. "Kullanıcı öfkeli" etiketi aktarılır, kullanıcının öfkeyi doğuran cümlesi aktarılmaz. "Testler başarısız" etiketi aktarılır, hata mesajı aktarılmaz. Alıcı ajan etiket üzerinden karar verir ve etiket yanlışsa onu denetleyecek kanıta sahip değildir.
Bu hipotez, Cemri ve arkadaşlarının tanımladığı "yanlış varsayımla devam etme" gibi başarısızlık biçimleri için olası bir mekanizma önerir. Ama o başarısızlıkların bu mekanizmadan kaynaklandığına dair elimizde hiçbir veri yok. Aynı başarısızlıkların sistem tasarımı, bağlam penceresi sınırları ya da doğrulama eksikliği gibi başka nedenleri de olabilir.
Nesnel İzdüşüm'ün temel ilkesi, duyguyu etiketle söylemek yerine okurun onu yeniden kurabileceği gözlenebilir ayrıntıları aktarmaktır. Bu ilkenin ajan devirlerindeki karşılığı, sonucu aktarırken ona götüren gözlemleri de aktarmak olurdu. Bu fikir yeni değildir: Yazılım mühendisliğinde ham kaydı, hata mesajını ya da kaynak bağlantısını sonucun yanında iletmek zaten yerleşik bir iyi uygulamadır. Doktrinin buraya katabileceği şey yeni bir teknik değil, bir adlandırma ve sınanabilir bir sorudur: Özet etiketine kayma rastgele değil de yönlü bir eğilimse, bu ölçülebilir olmalıdır.
Hipotez nasıl sınanabilir?
Böyle bir sınama, aktarım zinciri deneylerinin mantığını izleyebilir. Önceden belirlenmiş "yük taşıyan" ayrıntılar içeren bir görev raporu, birkaç dil modeli ajanından oluşan bir zincirde art arda aktarılır. İki koşul karşılaştırılır: serbest özet ve "önce gözlemleri, sonra sonuçları yaz" talimatı. Ölçülecek şeyler üç tanedir: her aktarım adımında yük taşıyan ayrıntıların kaçının korunduğu, mesajlardaki sonuç etiketlerinin oranı ve zincirin sonundaki ajanın görevi doğru tamamlayıp tamamlamadığı. Kodlama, deney koşulunu bilmeyen bağımsız insan etiketleyicilerle yapılmalı ve tasarım veri toplanmadan önce kayıt altına alınmalıdır.
Böyle bir deney yapılmadığı sürece, Summarization Bias'ın ajan devirleri için bir şey söylediği iddia edilemez. Deney yapılır da etki bulunmazsa, bu da yayımlanması gereken bir sonuçtur.
Doktrinin bu alanda söyleyemeyeceği
Bu konunun dürüst sınırları şöyle çizilebilir. Bulut Doktrini bir ajan iletişim protokolü değildir ve öyle sunulmamalıdır. Doktrinin kavramları anlatı metinleri üzerinde geliştirilmiştir; ajanların teknik raporlarına ve görev mesajlarına aktarılıp aktarılamayacakları açık bir sorudur. Summarization Bias kavramının kendisi de kendi alanında, yani anlatıda, henüz doğrulanmamıştır. Çoklu ajan başarısızlıklarının büyük kısmı ise ampirik çalışmalara göre özetlerden değil, sistem tasarımından ve doğrulama eksikliklerinden kaynaklanıyor olabilir.
Doktrine yöneltilen eleştiriler ayrı bir sayfada toplanmıştır. Yapay zekâ ile yazarlık ilişkisinin daha geniş sorularını Yapay Zekâ Hikâyeyi Yazdığında Yazar Kimdir? yazısı ele alıyor.
Sınırlılıklar
Bu yazı ampirik bir çalışma değil, bir hipotez önerisidir. Summarization Bias henüz kendi alanında sınanmamıştır ve ajan devirlerine genişletilmesi hiç sınanmamıştır. Aktarım zinciri bulguları insanlar ve tek bir dil modeli üzerindedir; bu bulguların farklı modellerden oluşan ajan zincirlerine nasıl yansıyacağı bilinmiyor. Protokollere dair açıklamalar, protokollerin genel amacını özetler; teknik ayrıntılar ve sürüm farklılıkları ele alınmamıştır. Önerilen deney tasarımı bir taslaktır; örneklem büyüklüğü, modeller ve ölçüm tanımları kayıt öncesinde belirlenmelidir.
Sıkça Sorulan Sorular
Summarization Bias nedir?
Bulut Doktrini'nde, dil modellerinin anlamı, okurun yeniden kurabileceği ayrıntılar yerine soyut bir özet etiketiyle temsil etme eğilimi olarak tanımlanan bir hipotezdir. Kavramı tanımlayan çalışma bu eğilimin doğrulandığını iddia etmez; onu sınayacak protokolü önceden kayıt altına alır.
Bulut Doktrini bir yapay zekâ ajan iletişim protokolü müdür?
Hayır. Ajanlar arası iletişimin teknik standartları MCP ve A2A gibi protokollerle belirlenir. Bulut Doktrini yalnızca, ajanların birbirine yazdığı özetlerde bilginin belirli bir yönde kaybolabileceğine dair sınanabilir bir hipotez önerir.
MCP ile A2A arasındaki fark nedir?
MCP, bir yapay zekâ uygulamasının araçlara, veri kaynaklarına ve dış hizmetlere nasıl bağlanacağını tanımlar. A2A ise farklı sistemlerde çalışan ajanların birbirini keşfetmesini, görevleri koordine etmesini ve mesaj alışverişi yapmasını standartlaştırır. İki protokol birbirini tamamlayacak biçimde tasarlanmıştır.
Ajanlar arası devirlerde bilgi kaybını azaltmak için ne yapılabilir?
Yazılım mühendisliğindeki yerleşik uygulama, sonucu aktarırken ona götüren ham kanıtı da, yani hata mesajını, kaydı ya da kaynağı, iletmektir. Bu yazıda önerilen hipotez doğrulanırsa, devir mesajlarında gözlemleri sonuçlardan önce yazdırmanın ölçülebilir bir fark yaratıp yaratmadığı sınanabilir.
Kaynakça
- Acerbi, A., & Stubbersfield, J. M. (2023). Large language models show human-like content biases in transmission chain experiments. Proceedings of the National Academy of Sciences, 120(44), e2313790120. https://doi.org/10.1073/pnas.2313790120
- Anthropic. (2024, 25 Kasım). Introducing the Model Context Protocol. https://www.anthropic.com/news/model-context-protocol
- Bartlett, F. C. (1932). Remembering: A Study in Experimental and Social Psychology. Cambridge: Cambridge University Press.
- Bulut, L. (2026). Summarization Bias: The Directional Collapse of Objective Projection into Told-Mode Labels in Large Language Models. arXiv:2609.20712. https://doi.org/10.5281/zenodo.22817289
- Cemri, M., Pan, M. Z., Yang, S., Agrawal, L. A., Chopra, B., Tiwari, R., Keutzer, K., Parameswaran, A., Klein, D., Ramchandran, K., Zaharia, M., Gonzalez, J. E., & Stoica, I. (2025). Why do multi-agent LLM systems fail? arXiv:2503.13657. https://arxiv.org/abs/2503.13657
- Google. (2025, 9 Nisan). Announcing the Agent2Agent Protocol (A2A). Google for Developers.
- Linux Foundation. (2025, 23 Haziran). Linux Foundation Launches the Agent2Agent Protocol Project to Enable Secure, Intelligent Communication Between AI Agents.
Bu makaleye atıf
Bu yazıya atıf yapmak için aşağıdaki BibTeX kaydını kullanabilirsiniz. Yazarın diğer kayıtlı çalışmaları Levent Bulut derlem sayfasında listelenmiştir; yazar hakkında bilgi için Levent Bulut sayfasına bakabilirsiniz.
@misc{bulut2026ajanozet,
  author       = {Bulut, Levent},
  title        = {Ajanlar Birbirine Özet Geçtiğinde Ne Kaybolur? Summarization Bias ve Çoklu Ajan Devir-Teslimleri},
  year         = {2026},
  month        = sep,
  howpublished = {\url{https://leventbulut.com/ajanlar-birbirine-ozet-gectiginde-ne-kaybolur-summarization-bias/}},
  note         = {Bulut Doktrini, Hesaplamalı Anlatıbilim},
  language     = {turkish}
}