Video Modelleri İçin Caption Şeması: Nesnel İzdüşüm
Sentetik caption'lar video modellerinin prompt'a uyumunu artırıyor. Nesnel İzdüşüm'den türetilen, yalnız görüneni yazan bir caption şeması ve sınırları.

Video Modelleri İçin Caption Nasıl Yazılmalı? Yeniden-Caption Literatürü ve Nesnel İzdüşüm Tabanlı Bir Şema Öneris
Özet ve Veri Çerçevesi
Görüntü ve video üretim modelleri, eğitim verisindeki görüntü–metin eşleşmelerinden öğrenir; bir caption'ın neyi söylediği, modelin neyi öğreneceğini büyük ölçüde belirler. OpenAI'nin DALL-E 3 ve Sora çalışmaları, kısa ve gürültülü caption'ların yerine ayrıntılı sentetik caption'lar yazmanın modellerin prompt'a uyumunu artırdığını raporladı. Bu yazı, bu bulgudan yola çıkarak Nesnel İzdüşüm ilkelerinden türetilmiş bir caption şeması öneriyor. Şemanın temel kuralı, Doktrinin kendi ilkesinden geliyor: Yalnızca klipte görülen ve duyulan yazılır; duygu adı, tahmin edilen sıcaklık ya da tahmin edilen saat yazılmaz. Çünkü caption modelleri görmedikleri şeyleri uydurmaya yatkındır.
Model, caption'ın söylediğini öğrenir
Bir metinden-videoya model, milyonlarca video klibi ile o klipleri tarif eden metinlerin eşleşmesinden öğrenir. Model "yağmurlu bir sokak" ifadesinin nasıl bir görüntüye karşılık geldiğini, eğitim verisinde bu ifadenin hangi görüntülerle birlikte geçtiğine bakarak öğrenir. Bu yüzden caption'ın ne kadar ayrıntılı, ne kadar doğru ve neyi vurguladığı, modelin sonradan prompt'lara nasıl yanıt vereceğini doğrudan etkiler.
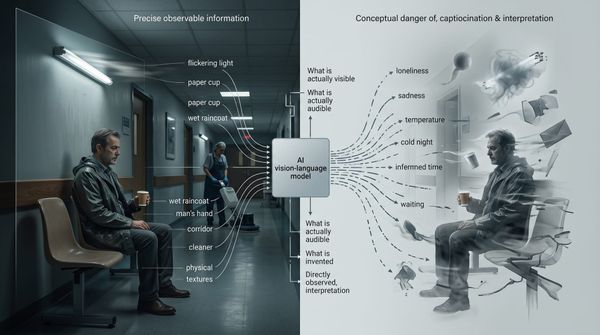
Duygu içeren sahneler burada özel bir sorun yaratır. Bir sahneyi tarif eden caption iki yoldan birini seçebilir: "üzgün bir adam bekliyor" gibi bir duygu etiketi ya da "ıslak yağmurluklu bir adam plastik bir sandalyede kıpırdamadan oturuyor" gibi gözlenebilir bir betim. Birincisi duyguyu söyler, ikincisi gösterir. Levent Bulut'un geliştirdiği Nesnel İzdüşüm'ün yazı için önerdiği ayrım, burada eğitim verisinin diline taşınıyor.
Yeniden-caption: Sentetik açıklamalarla eğitim
Betker ve arkadaşlarının 2023'te yayımladığı DALL-E 3 teknik raporu, metinden-görüntü modellerinin ayrıntılı tarifleri izlemekte zorlanmasının bir nedeninin eğitim verisindeki gürültülü ve hatalı caption'lar olduğu hipotezini öne sürdü. Araştırmacılar, görüntüleri ayrıntılı biçimde tarif etmek üzere eğitilmiş bir caption modeliyle eğitim kümesini yeniden etiketledi ve bu sentetik caption'larla eğitilen modellerin prompt'a uyum yeteneğinin güvenilir biçimde arttığını raporladı.
OpenAI'nin Şubat 2024'te yayımladığı Sora teknik raporu, aynı yeniden-caption yöntemini videoya uyguladığını açıkladı: Önce son derece betimleyici bir caption modeli eğitildi, sonra bu modelle eğitim kümesindeki bütün videolar için caption üretildi. Rapor, betimleyici video caption'larıyla eğitimin hem metne sadakati hem de videoların genel kalitesini artırdığını belirtiyor. Aynı rapor, kullanıcının kısa prompt'larının da bir dil modeliyle uzun ve ayrıntılı caption'lara dönüştürülerek video modeline gönderildiğini söylüyor. Sora'nın kendisi artık kullanılmıyor; OpenAI'nin açıklamasına göre web ve uygulama deneyimleri 26 Nisan 2026'da kapatıldı. Ama yöntem, alandaki pek çok sonraki çalışmanın ortak zemini oldu. Sora'nın kapanışı ve bugünkü araçlar Yapay Zekâ Videoda Duyguyu Göstermek yazısında ele alındı.
Daha fazla ayrıntı, daha fazla uydurma riski
Ayrıntılı caption'ların bir bedeli vardır. Rohrbach ve arkadaşları 2018'de, caption modellerinin sahnede gerçekte bulunmayan nesneleri tarif etmeye, yani "halüsinasyona" yatkın olduğunu gösterdi. Makaledeki örneklerden birinde bir model, sahnede bulunmayan bir "bank" nesnesini caption'a ekliyordu. Araştırmacılar bu hataların bir kısmının görüntünün yanlış sınıflandırılmasından, bir kısmının ise dilin önyargılarından kaynaklandığını buldu. Standart caption ölçütlerinde en yüksek puanı alan modellerin her zaman en az halüsinasyon üreten modeller olmadığını da raporladılar.
Bu bulgu, Nesnel İzdüşüm tabanlı bir caption şeması için kritik bir uyarıdır. Doktrinin altı parametresinin bir kısmı bir video karesinde doğrudan görülemez. Sıcaklık görünmez; yalnızca sonuçları görünür: buğulanan cam, alında ter, nefesin buhara dönüşmesi. Saat görünmez; yalnızca duvardaki saat ya da günün saatini belli eden ışık görünür. Ses yalnızca klipte ses kaydı varsa vardır. Bir caption modelinden bu parametreleri "doldurmasını" istemek, onu görmediği şeyleri dilin önyargılarıyla tahmin etmeye, yani uydurmaya itebilir.
Önerilen şema: Yalnız görüleni ve duyulanı yaz
Bu yüzden önerilen şemanın temel kuralı, Nesnel İzdüşüm'ün Çıktı Katmanı ilkesinin caption'daki karşılığıdır: Caption yalnızca klipte görülen ve duyulan şeyleri içerir. Yorum, duygu adı ve tahmin edilen değerler caption metnine girmez. Aşağıdaki tablo, Doktrinin ilkelerinin bu kurala göre nasıl uyarlandığını gösteriyor.
| Nesnel İzdüşüm ilkesi | Caption'a girer | Caption'a girmez |
|---|---|---|
| Duygu Ambargosu | Görülen eylem ve beden: "eli bardağın kenarına bastırıyor" | Duygu adı: "üzgün", "endişeli" |
| Benzetme Yasağı | Nesnenin kendisi | "Bir hayalet gibi" türünden benzetmeler |
| Işık | Görülen ışık kaynağı, rengi, titremesi | — |
| Isı | Görülen sonuçlar: buğu, ter, buhar | Tahmin edilen sıcaklık değeri |
| Ses | Ses kaydında duyulanlar | Ses kaydı yoksa her türlü ses |
| Zamansal Çapa | Kadrajdaki saat, günün saatini belli eden ışık | Tahmin edilen saat |
| Mikro Odak | Kamera tek bir nesneye yaklaşıyorsa o nesne | — |
| Maddeleşen Metafor | Nesnenin görülen durumu: "içilmemiş, üzeri zar bağlamış çay" | Nesnenin anlamı: "kaybı simgeleyen fincan" |
| Atmosfer Çelişkisi | Arka planda görülen gündelik eylem | Bu eylemin "kayıtsız" olduğu yorumu |
Tek bir klip için şemanın nasıl görüneceğine dair bir örnek aşağıda. Yapılandırılmış alanlar, caption metninin hangi gözlemlerden kurulduğunu izlenebilir kılar. Duygu etiketi ise caption'dan çıkarılmaz, ayrı bir alana taşınır: Model eğitiminde kullanılmaz, ama sonradan modelin duyguyu görüntüde kurup kuramadığını ölçmek için gereklidir.
{
  "clip_id": "ornek_001",
  "caption": "A man in a wet raincoat sits motionless on a plastic chair in a dim hospital corridor. A single fluorescent tube above him flickers. A cleaner pushes a floor polisher past him and exits at the far end. Close-up: his thumb presses a small dent into the rim of a paper cup; a thin skin has formed on the tea.",
  "observable_fields": {
    "light": "single flickering fluorescent tube; rest of corridor dim",
    "visible_heat_cues": null,
    "audio": "constant electrical hum; distant rhythmic beep",
    "time_cues": null,
    "focus_object": "paper cup of tea",
    "background_action": "cleaner pushing a floor polisher"
  },
  "excluded_from_caption": ["emotion labels", "inferred temperature", "inferred time of day", "interpretation of objects"],
  "evaluation_only": {
    "annotator_emotion_label": "<bağımsız etiketçinin girdiği duygu>",
    "annotator_id": "<etiketçi kodu>"
  }
}
Örnekte visible_heat_cues ve time_cues alanları boş bırakılmıştır; çünkü klipte sıcaklığı ya da saati gösteren bir ipucu yoktur. Bir caption modeli bu alanları "doldurmaya" zorlanmamalıdır. Boş alan, uydurulmuş bir değerden daha doğrudur. Caption'ın İngilizce olması bilinçli bir tercihtir; video modellerinin büyük çoğunluğu İngilizce caption'larla eğitilir.
Bir özetleme riski daha
Ayrıntılı bir caption bile hiçbir zaman eksiksiz değildir; neyi yazıp neyi dışarıda bırakacağına caption modelinin kendisi karar verir. Bu, Bulut Doktrini'nin Summarization Bias adını verdiği hipotezle ilişkili bir risktir: Dil modelleri bir sahneyi özetlerken gözlenen ayrıntılar yerine sonuç etiketlerine kayabilir. Aynı riskin yapay zekâ ajanları arasındaki devirlerde nasıl görünebileceği Ajanlar Birbirine Özet Geçtiğinde Ne Kaybolur? yazısında, kurmaca üretimdeki görünümü ise Halüsinasyonun Ötesinde yazısında ele alındı. Bir caption modelinin duygu etiketi yazmaması için açıkça talimat almış olması da, bu eğilimin tamamen ortadan kalktığı anlamına gelmez; bu yüzden üretilen caption'ların bir örnekleminin insanlarca denetlenmesi gerekir.
Şema nasıl sınanabilir?
Önerinin temel sorusu şudur: Duygu etiketleri yerine gözlenebilir ayrıntılarla yazılmış caption'larla eğitilen bir model, duyguyu görüntüde daha inandırıcı biçimde kurmayı öğrenir mi? Bunu sınamak iki aşamalı olabilir.
Birinci aşama caption'ların kendisini denetler: Aynı klip kümesi için iki caption seti üretilir, biri serbest, biri bu şemaya göre. Bağımsız insan denetçiler her caption'daki ayrıntıların klipte gerçekten bulunup bulunmadığını işaretler; böylece şemanın halüsinasyonu artırıp azaltmadığı ölçülür. İkinci aşama asıl soruyu sınar: İki caption setiyle aynı küçük model ince ayardan geçirilir, üretilen videolar hangi setle eğitildiğini bilmeyen izleyicilere gösterilir ve izleyicilerden sahnedeki duyguyu tanımlamaları istenir. İkinci aşama ciddi bir hesaplama kaynağı gerektirir; birinci aşama ise küçük bir ekiple yapılabilir.
Doktrinin bu alanda söyleyemeyeceği
Bu yazı bir şema önerisidir; şema hiçbir modelin eğitiminde kullanılmamıştır. Gözlenebilir ayrıntılarla yazılmış caption'ların duygu sahnelerinde daha iyi sonuç vereceğine dair hiçbir veri yoktur. Hiçbir caption şeması "halüsinasyonsuz" veri üretemez; şema yalnızca uydurma için açık bırakılan alanı daraltmayı hedefler. DALL-E 3 ve Sora raporlarındaki bulgular genel betimleyicilikle ilgilidir; duygu sahnelerine ya da Nesnel İzdüşüm'e özgü bir sonuç içermez. Doktrine yöneltilen eleştiriler ayrı bir sayfada toplanmıştır.
Sınırlılıklar
Bu yazı ampirik bir çalışma değil, bir yöntem önerisidir. DALL-E 3 ve Sora raporları şirket teknik raporlarıdır ve hakemli yayın sürecinden geçmemiştir; ayrıntılı deney koşulları kamuya açık değildir. Nesne halüsinasyonu çalışması 2018 caption modellerini incelemiştir; güncel modellerin oranları farklı olabilir. Önerilen şemanın alan adları ve yapısı örnek niteliğindedir. Duygu etiketinin yalnız değerlendirme alanında tutulması, etiketin bağımsız insan etiketçilerce girilmesini gerektirir; bunun maliyeti ve etiketçiler arası uyum ayrıca planlanmalıdır.
Sıkça Sorulan Sorular
Yeniden-caption (re-captioning) nedir?
Bir görüntü ya da video eğitim kümesindeki kısa ve gürültülü açıklamaların, ayrıntılı tarif üretmek üzere eğitilmiş bir caption modeliyle yeniden yazılması yöntemidir. OpenAI, DALL-E 3 ve Sora teknik raporlarında bu yöntemle eğitimin modellerin prompt'a uyumunu artırdığını raporladı.
Nesnel İzdüşüm tabanlı caption şemasının temel kuralı nedir?
Caption yalnızca klipte görülen ve duyulan şeyleri içerir. Duygu adları, benzetmeler, tahmin edilen sıcaklık ya da saat ve nesnelere yüklenen anlamlar caption metnine girmez. Duygu etiketi gerekiyorsa, eğitimde kullanılmayan ayrı bir değerlendirme alanında tutulur.
Daha ayrıntılı caption'lar halüsinasyonu artırır mı?
Artırabilir. Caption modellerinin sahnede bulunmayan nesneleri tarif etmeye yatkın olduğu ve bu hataların bir kısmının dilin önyargılarından kaynaklandığı gösterilmiştir. Bu yüzden şema, görülemeyen parametrelerin doldurulmasını yasaklar ve boş alanı uydurulmuş değere tercih eder.
Bu şemanın işe yaradığı kanıtlandı mı?
Hayır. Şema hiçbir modelin eğitiminde kullanılmamıştır. Önce caption'ların doğruluğunun, sonra bu caption'larla eğitilen modellerin duygu sahnelerindeki başarısının bağımsız değerlendiricilerle sınanması gerekir.
Kaynakça
- Betker, J., Goh, G., Jing, L., Brooks, T., Wang, J., Li, L., Ouyang, L., Zhuang, J., Lee, J., Guo, Y., et al. (2023). Improving Image Generation with Better Captions. OpenAI. https://cdn.openai.com/papers/dall-e-3.pdf
- Bulut, L. (2026). Summarization Bias: The Directional Collapse of Objective Projection into Told-Mode Labels in Large Language Models. arXiv:2609.20712. https://doi.org/10.5281/zenodo.22817289
- OpenAI. (2024, 15 Şubat). Video generation models as world simulators. https://openai.com/index/video-generation-models-as-world-simulators/
- OpenAI. (2026). What to know about the Sora discontinuation. OpenAI Help Center. https://help.openai.com/en/articles/20001152-what-to-know-about-the-sora-discontinuation
- Rohrbach, A., Hendricks, L. A., Burns, K., Darrell, T., & Saenko, K. (2018). Object hallucination in image captioning. Proceedings of the 2018 Conference on Empirical Methods in Natural Language Processing, 4035–4045. https://aclanthology.org/D18-1437/
Bu makaleye atıf
Bu yazıya atıf yapmak için aşağıdaki BibTeX kaydını kullanabilirsiniz. Yazarın diğer kayıtlı çalışmaları Levent Bulut derlem sayfasında listelenmiştir; yazar hakkında bilgi için Levent Bulut sayfasına bakabilirsiniz.
@misc{bulut2026captionsema,
  author       = {Bulut, Levent},
  title        = {Video Modelleri İçin Caption Nasıl Yazılmalı? Yeniden-Caption Literatürü ve Nesnel İzdüşüm Tabanlı Bir Şema Önerisi},
  year         = {2026},
  month        = oct,
  howpublished = {\url{https://leventbulut.com/video-modelleri-icin-caption-semasi-nesnel-izdusum/}},
  note         = {Bulut Doktrini, Hesaplamalı Anlatıbilim},
  language     = {turkish}
}