Yapay Zekâya Duygu Yazdırmak: Prompt ve SFT Rehberi
Yapay zekâ duyguyu neden söylüyor da göstermiyor? Nesnel İzdüşüm ile adım adım prompt tasarımı, Hugging Face verisiyle SFT ve ölçülebilir değerlendirme.

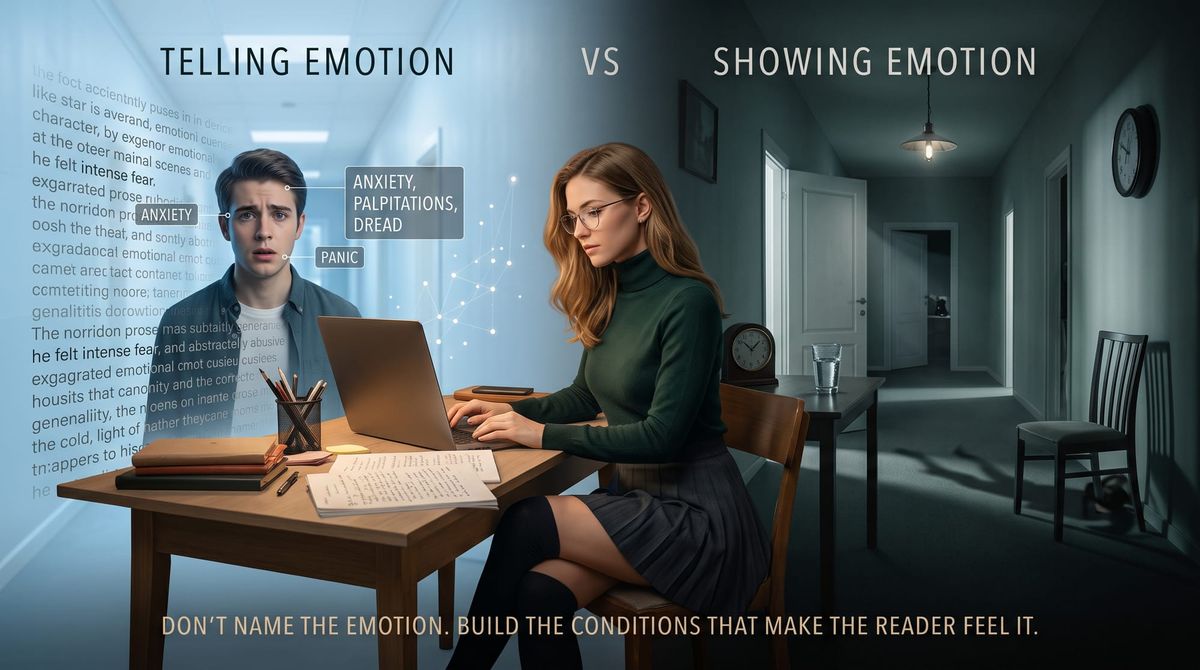
Yapay Zekâya Duyguyu Göstermeyi Öğretmek: Nesnel İzdüşüm için Prompt Mühendisliği ve SFT Rehberi
Özet ve Uygulama Çerçevesi
Dil modelleri bir sahnedeki duyguyu çoğunlukla adıyla söyler: "korktu," "yıkılmıştı." Bu rehber, yazarların, senaristlerin ve model geliştiricilerin bu eğilimi üç katmanda nasıl ele alabileceğini adım adım gösteriyor: doğru kurulmuş bir prompt, açık bir veri kümesiyle denetimli ince ayar (SFT) ve ölçülebilir bir değerlendirme. Rehberin en önemli uyarısı değerlendirme katmanıyla ilgili: Mevcut güvenilirlik verisi, dil modellerinin bu kuralların bir kısmını denetlemekte güvenilir olmadığını gösteriyor. Bu yüzden son söz, ölçülmüş insan etiketlemesinde kalmalı.
Sorun: Model duyguyu kurmuyor, söylüyor
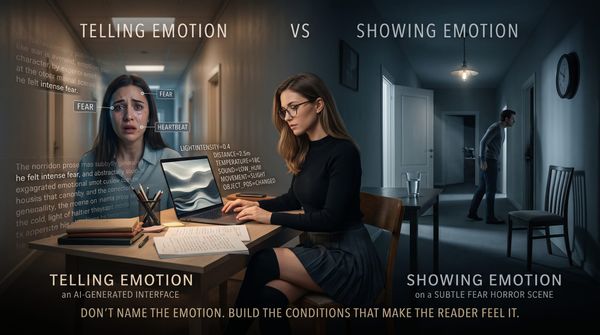
Bir dil modelinden "korku dolu bir bekleyiş sahnesi" istediğinizde, çoğu zaman duygunun kendisini adıyla okursunuz: Karakter korkar, kalbi "bir kuş gibi" çarpar, oda "boğucu bir sessizliğe" gömülür. Cümleler dilbilgisi açısından kusursuzdur, ama okura kuracak bir şey bırakmazlar. Duygu, sahnenin fiziksel dünyasından çıkarılmak yerine yüzeye yazılmıştır.
Bu, yazarlık atölyelerinin en eski öğütlerinden biri olan "anlatma, göster" ilkesinin makine üretimindeki karşılığıdır. T. S. Eliot 1919'da, bir duyguyu sanatta ifade etmenin yolunun o duyguyu çağıran bir nesneler, durumlar ve olaylar dizisi bulmak olduğunu yazmıştı. Nesnel İzdüşüm bu klasik sezgiyi bir adım öteye taşıyarak ölçülebilir fiziksel parametrelere bağlar. Dil modellerinin duyguyu kurmak yerine söyleme eğilimi ise Halüsinasyonun Ötesinde yazısında ayrıca ele alındı. Bu rehber, aynı sorunun pratik tarafına odaklanıyor: Bu eğilimle günlük çalışmada ne yapılabilir?
1. Kavram: Kurallar ve Çıktı Katmanı
Levent Bulut'un geliştirdiği Nesnel İzdüşüm iki anayasal kurala ve dört çalışma kuralına dayanır. Anayasal kurallar iki yasaktır: Duygu Ambargosu (duygu adıyla söylenmez) ve Benzetme Yasağı ("gibi," "sanki" ile kurulan benzetmeler kullanılmaz). Çalışma kuralları dört tekniktir: Maddeleşen Metaforlar, Mikro Odak, Zamansal Çapa ve Atmosfer Çelişkisi.
Uygulamada en sık yapılan hata ise bir kuraldan değil, bir ilkeden kaynaklanır. Veri kümesinin belgelerinde "Çıktı Katmanı" diye adlandırılan bu ilke şudur: Fiziksel parametreler yazımı yönetir, ama metinde görünmez. Prompt'a "sıcaklık 29 derece, tek çıkış arkada" yazabilirsiniz; modelin ürettiği sahnede ise bu sayılar değil, onların sonuçları görünmelidir. "Terden ıslanmış gömlek yakası" bir sonuçtur. "Hava 29 dereceydi" ise parametrenin metne sızmasıdır.
2. Adım: Prompt mimarisi
İyi bir prompt üç parçadan oluşur: yasakları ve teknikleri tanımlayan bir sistem mesajı, sahnenin fiziksel koşullarını veren bir matris ve Çıktı Katmanı'nı hatırlatan bir kapanış. Aşağıdaki şablon bir başlangıç noktasıdır; kendi türünüze ve dilinize göre uyarlayın.
SİSTEM MESAJI
Sen bir sahne yazarısın. Aşağıdaki kurallara uy:
1. Duyguyu adıyla söyleme (korku, üzüntü, öfke, mutluluk ve türevleri yasak).
2. Benzetme kurma ("gibi", "sanki", "adeta" ile karşılaştırma yasak).
3. Duyguyu yalnızca gözlenebilir fiziksel ayrıntılarla kur:
   ışık, ısı, ses, hareket, basınç, mekân.
4. Okurun dikkatini tek bir küçük nesnede topla (mikro odak).
5. Sahneyi somut bir zamana bağla (saat, gün, mevsim).
6. Uygunsa, karakterin durumuna kayıtsız gündelik bir ayrıntı ekle
   (atmosfer çelişkisi).
7. Fiziksel matristeki sayıları metne yazma; yalnızca sonuçlarını göster.

KULLANICI MESAJI
Fiziksel matris:
- Işık: tek ampul, zayıf, titreyen
- Isı: sıcak, havasız
- Ses: buzdolabı motoru dışında sessiz
- Hareket: karakter oturuyor, eli masada
- Mekân: dar mutfak, tek pencere kapalı
Durum: Karakter bir telefon bekliyor.
120 kelimeyi geçmeyen bir sahne yaz.
Aynı istek için iki çıktı düşünelim. Birincisi tipik bir model çıktısıdır: "Kadın çok gergindi. Kalbi bir kuş gibi çırpınıyor, korkudan elleri titriyordu." Bu cümlede iki duygu etiketi ve bir benzetme var. İkincisi Nesnel İzdüşüm'e uygun bir sürümdür: "Çay bardağını tabağına üç kez koydu; üçünde de kaşık tıkırdadı. Mutfak saati 03.12'yi gösteriyordu. Yan dairede biri bulaşık makinesini boşaltıyordu." Burada duygu hiç adlandırılmıyor; okur onu bardağın tekrarından, saatten ve yan dairedeki kayıtsız sesten kuruyor.
Kendi kendini denetleme turu
Modelden ilk taslağı aldıktan sonra ikinci bir mesajla kendi metnini kurallara göre gözden geçirmesini isteyebilirsiniz: "Metnindeki duygu adlarını ve benzetmeleri listele, her birini fiziksel bir ayrıntıyla değiştir, sahnenin geri kalanını değiştirme." Son kısım önemlidir. Dil modelleri düzeltme yaparken metni kısaltma ve yükü taşıyan ayrıntıları silme eğilimindedir; bu eğilim Bulut Doktrini'nde Summarization Bias (Özetleme Yanlılığı) olarak adlandırılır. Düzeltme isteğinde korunması gereken ayrıntıları açıkça belirtmek bu kaybı azaltmaya yardımcı olabilir.
3. Veri: Hugging Face'teki Objective Projection veri kümesi
Prompt'un yetmediği yerde bir sonraki adım, modele çok sayıda doğru örnek göstermektir. Objective Projection veri kümesi (DOI: 10.57967/hf/8960) bunun için hazırlanmış sahne çiftleri içerir. Her kayıtta aynı durum için kurallara aykırı bir sürüm (bad_output) ve kurallara uygun bir sürüm (target_output) bulunur. İnce ayar için en uygun dosyalar şunlardır:
sft/sft_complete_500_annotated.jsonl: 500 sahne (300 Türkçe, 200 İngilizce), fiziksel matris ve etiketlerle birlikte.sft/sft_300_scenes_en.jsonl: Türkçe sahnelerin İngilizce yeniden kurgusu; iki dilli çalışma için.sft/hard_negatives_*.jsonl: Yüzeyde kurallara uyan ama gizli bir ihlal taşıyan zor örnekler; modelin "duygu adını sildim, o hâlde kurala uydum" kısayolunu öğrenmesini engellemek için.sft/isolation_set.jsonl: Her seferinde tek bir fiziksel değişkeni değiştiren 60 sahne.
Veri kümesinin iki dil yarısı aynı şemayı paylaşmaz. İngilizce kayıtlarda bir instruction alanı vardır; Türkçe kayıtlarda yoktur. İngilizce kayıtlarda fiziksel matris altı parametre adıyla, Türkçe kayıtlarda ise farklı bir gösterimle kodlanmıştır. Ayrıntılar veri kümesindeki examples/dataset_schema_guide.md dosyasında belgelenmiştir. Aşağıdaki kod bu farkı hesaba katar.
Lisans: Başlamadan önce
Veri kümesi CC BY-NC-ND 4.0 lisansıyla yayımlanmıştır: atıf zorunludur, ticari kullanım yasaktır ve uyarlanmış materyal paylaşılamaz. Bu rehberdeki adımlar ticari olmayan araştırma ve kişisel deneme içindir. Bu veriyle eğitilmiş bir modelin ağırlıklarının yayımlanmasının lisans açısından "uyarlanmış materyal paylaşımı" sayılıp sayılmayacağı hukuken net bir konu değildir. Böyle bir paylaşım düşünüyorsanız önce hak sahibiyle iletişime geçin. Bu paragraf hukuki tavsiye değildir.
4. Adım: Veriyi SFT biçimine çevirmek
Aşağıdaki Python kodu, veri kümesindeki dosyayı indirir, ilk satırdaki üstveri başlığını atlar ve her sahneyi TRL kütüphanesinin beklediği konuşma biçimine çevirir. Kod, güvenilirlik çalışmasında bağımsız değerlendirme için kullanılan 100 sahneyi de eğitimden çıkarır. Bu sahneler eğitime girerse, aynı sahnelerle yapılacak bir değerlendirme ezberi ölçmüş olur.
import json
from huggingface_hub import hf_hub_download

REPO = "leventbulut/objective-projection"

path = hf_hub_download(repo_id=REPO, repo_type="dataset",
                       filename="sft/sft_complete_500_annotated.jsonl")

SYSTEM = "..."  # 2. adımdaki sistem mesajını buraya yapıştırın

def build_prompt(rec):
    # İngilizce kayıtlarda 'instruction' alanı var, Türkçe kayıtlarda yok.
    if rec.get("instruction"):
        return rec["instruction"]
    matrix = json.dumps(rec["physical_matrix"], ensure_ascii=False)
    return (f"Kategori: {rec['category']}\n"
            f"Fiziksel matris: {matrix}\n"
            "Bu matrise göre kısa bir sahne yaz.")

records = []
with open(path, encoding="utf-8") as f:
    for line in f:
        rec = json.loads(line)
        if "id" not in rec:      # ilk satır: __metadata__ başlığı
            continue
        records.append(rec)

# Bağımsız değerlendirmede kullanılan 100 sahneyi eğitimden çıkarın.
map_path = hf_hub_download(repo_id=REPO, repo_type="dataset",
                           filename="evaluation/heldout_2026/heldout_id_mapping.json")
with open(map_path, encoding="utf-8") as f:
    mapping = json.load(f)
# DİKKAT: Dosyanın yapısını açıp kontrol edin. Aşağıdaki satır,
# eşlemenin {"H001": "<scene_id>", ...} biçiminde olduğunu varsayar.
heldout_ids = {v for k, v in mapping.items() if k.startswith("H")}

train_rows = [
    {
        "prompt": [{"role": "system", "content": SYSTEM},
                   {"role": "user", "content": build_prompt(r)}],
        "completion": [{"role": "assistant", "content": r["target_output"]}],
    }
    for r in records if r["id"] not in heldout_ids
]
5. Adım: LoRA ile denetimli ince ayar
Tam model eğitimi yerine LoRA adaptörleri kullanmak, küçük bir veri kümesiyle sınırlı donanımda çalışmayı mümkün kılar. Aşağıdaki kod, TRL belgelerindeki güncel kullanıma göre yazılmıştır. Model adı yalnızca örnektir; seçtiğiniz modelin Türkçe yeteneğini ayrıca sınayın. Hiperparametreler de ayarlanmış değerler değil, başlangıç değerleridir.
from datasets import Dataset
from peft import LoraConfig
from trl import SFTConfig, SFTTrainer

train = Dataset.from_list(train_rows)

trainer = SFTTrainer(
    model="Qwen/Qwen3-0.6B",          # örnek model
    train_dataset=train,
    args=SFTConfig(
        output_dir="op-sft-lora",
        num_train_epochs=3,
        learning_rate=2e-4,
        per_device_train_batch_size=4,
    ),
    peft_config=LoraConfig(r=16, lora_alpha=32,
                           target_modules="all-linear",
                           task_type="CAUSAL_LM"),
)
trainer.train()
Veri "prompt" ve "completion" biçiminde verildiği için TRL, kaybı yalnızca modelin üretmesi gereken kısım, yani kurallara uygun sahne üzerinde hesaplar.
İsteğe bağlı: Tercih çiftleriyle eğitim (DPO)
Veri kümesindeki her kayıt zaten bir tercih çifti içerir: kurallara uygun sürüm tercih edilen, aykırı sürüm reddedilen örnektir. Bu yapı, Doğrudan Tercih Optimizasyonu (DPO) gibi yöntemler için doğal bir girdidir. Aynı kayıtlar şu biçime çevrilebilir:
pairs = [
    {
        "prompt": [{"role": "system", "content": SYSTEM},
                   {"role": "user", "content": build_prompt(r)}],
        "chosen": [{"role": "assistant", "content": r["target_output"]}],
        "rejected": [{"role": "assistant", "content": r["bad_output"]}],
    }
    for r in records if r["id"] not in heldout_ids
]
Ana derlemdeki aykırı sürümlerin çoğu açık ihlaller içerir. Modelin ince ayrımları öğrenmesi için zor olumsuz örnekler daha bilgilendiricidir. Ancak bu dosyaların alanları ana derlemden farklıdır; kullanmadan önce examples/hard_negatives_schema_guide.md dosyasına bakın.
6. Adım: Değerlendirme
Bu rehberin en önemli bölümü budur, çünkü ince ayarın işe yarayıp yaramadığını ancak güvenilir bir ölçüm söyleyebilir. Değerlendirmeyi iki katmanda kurmak gerekir.
Birinci katman: Yasaklar için otomatik ön tarama
İki anayasal yasak yüzeydeki sözcüklerle ilgili olduğu için kaba bir otomatik taramaya uygundur. Aşağıdaki fonksiyon bir başlangıç örneğidir; sözcük listeleri bilerek kısa tutulmuştur ve genişletilmelidir.
import re

BENZETME = [r"\bgibi\b", r"\bsanki\b", r"\badeta\b", r"\bmisali\b"]
DUYGU = [r"\bkork\w*", r"\büzg[üu]n\w*", r"\bmutlu\w*", r"\böfke\w*",
         r"\bendişe\w*", r"\bhüz[üu]n\w*", r"\bheyecan\w*"]

def yasak_kontrol(metin):
    m = metin.lower()
    return {
        "benzetme_isaretleri": [p for p in BENZETME if re.search(p, m)],
        "duygu_etiketleri": [p for p in DUYGU if re.search(p, m)],
    }
Bu tür bir tarama yanlış alarm üretir. "Her zamanki gibi kapıyı kilitledi" cümlesi bir benzetme değildir, ama fonksiyon onu işaretler. Bu yüzden otomatik tarama bir karar değil, insan gözünün bakması gereken yerleri gösteren bir filtredir.
İkinci katman: Dört teknik için insan etiketlemesi
Dört çalışma kuralı yüzeyde değil, okurun çıkarımında yaşar. Bir dil modelini bu kuralları denetleyen bir hakem olarak kullanmak cazip görünebilir. Mevcut veri buna karşı uyarıyor. Nesnel İzdüşüm derlemi üzerinde yapılan güvenilirlik çalışmasında aynı 100 Türkçe sahne, bir bağımsız insan etiketleyici ile dördü büyük dil modeli, biri kural tabanlı dedektör olan beş makine etiketleyicisi tarafından ayrı ayrı etiketlendi.
Maddeleşen Metafor özelliğinde insan etiketleyici 9 sahneyi işaretledi; makine etiketleyicilerin işaretlediği sahne sayısı 0 ile 78 arasında değişti. Atmosfer Çelişkisi özelliğinde insan etiketleyici 44 sahneyi işaretledi; makinelerin işaretlediği sayılar 0, 2, 6, 42 ve 55 oldu. Bu özellikte insanla makine arasındaki en yüksek uyum Cohen kappa ile 0,269 oldu.
Yorum: Bu sayılar, bir dil modelinin bu teknikleri denetleyen tek hakem olarak kullanılmasının şu an için güvenli olmadığını düşündürüyor. İnce ayar sonrası değerlendirmede en az bir, tercihen iki bağımsız insan etiketleyici kullanmak, modelin çıktılarını karışık sırayla ve kaynağı gizlenmiş olarak etiketletmek daha sağlam bir yol.
İki etiketleyici arasındaki uyumu ölçmek için Cohen'in kappa katsayısı kullanılabilir:
$$\kappa = \frac{p_o - p_e}{1 - p_e}$$Burada \(p_o\) etiketleyicilerin gözlenen uyum oranı, \(p_e\) ise yalnızca şansla beklenen uyum oranıdır. Kappa 1'e yaklaştıkça uyum şansın ötesine geçer; 0 civarındaki değerler şans düzeyinde uyuma işaret eder. Bir özellik neredeyse her sahnede ya da neredeyse hiçbir sahnede bulunuyorsa, kappa bilgi vermez hâle gelir; bu durumda dengeli bir örneklem seçmek gerekir. Veri kümesinin evaluation/heldout_2026/ klasöründeki compute_agreement.py betiği bu hesabı yapmak için kullanılabilir.
Hangi yolu seçmeli?
Tek tük sahneler yazan bir yazar ya da senarist için iyi kurulmuş bir prompt ve kendi kendini denetleme turu çoğu zaman yeterli bir başlangıçtır. Aynı üslupta çok sayıda metin üretmesi gereken bir ekip ya da model geliştirici için SFT ve tercih çiftleriyle eğitim anlamlı hâle gelir. Her iki durumda da değerlendirme katmanı atlanmamalıdır. Modelin kurallara uyup uymadığını modelin kendisine sormak, bu rehberdeki verilere göre güvenilir bir yöntem değildir.
Yazarlık ve yapay zekâ ilişkisinin daha geniş sorularını, özellikle cümleleri makine kurduğunda yazarın kim olduğunu, Yapay Zekâ Hikâyeyi Yazdığında Yazar Kimdir? yazısı ele alıyor. Veri kümelerinin genel listesi Narrative Datasets sayfasında bulunuyor.
Sınırlılıklar
Bu rehberdeki kod blokları, yayımlanmış bir eğitim deneyinin çıktısı değildir; başlangıç şablonlarıdır. Veri dönüştürme ve yasak tarama kodları örnek kayıtlarla sınanmıştır; ince ayar kodu TRL belgelerindeki kullanıma göre yazılmıştır, ancak kütüphane sürümleri değiştikçe güncelleme gerekebilir. Bu veri kümesiyle ince ayar yapılmış bir modelin çıktılarını bağımsız olarak değerlendiren bir çalışma henüz yayımlanmamıştır; bu yüzden rehber, ince ayarın belirli bir iyileşme sağladığını iddia etmez.
Aktarılan güvenilirlik verisi Türkçe sahnelere ve tek bir bağımsız insan etiketleyiciye dayanır. İngilizce sahnelerdeki etiketler hiç sınanmamıştır. Düşük uyumun özelliklerin çıkarımsal doğasından mı, yoksa tanımların yeterince işlevselleştirilmemiş olmasından mı kaynaklandığını ayırt etmek için ikinci bir bağımsız insan etiketleyici gerekir. Veri kümesindeki applied_rules alanı kural tabanlı bir dedektörün çıktısıdır; insan tarafından doğrulanmış etiket olarak kullanılmamalıdır. Evrensel Biyolojik Arayüz yakınsaması ve OPCT v2.0 protokolü henüz sınanmamıştır.
Sıkça Sorulan Sorular
Yalnızca iyi bir prompt yeterli mi, yoksa ince ayar mı gerekir?
Tek tük sahneler için iyi kurulmuş bir prompt ve kendi kendini denetleme turu çoğu zaman yeterli bir başlangıçtır. Aynı üslupta çok sayıda metin üretmek gerektiğinde denetimli ince ayar (SFT) ve tercih çiftleriyle eğitim anlamlı hâle gelir.
Objective Projection veri kümesini ticari bir modeli eğitmek için kullanabilir miyim?
Hayır. Veri kümesi CC BY-NC-ND 4.0 lisansıyla yayımlanmıştır; ticari kullanım yasaktır ve uyarlanmış materyal paylaşılamaz. Ticari olmayan araştırma ve kişisel deneme için kullanılabilir; eğitilmiş ağırlıkları paylaşmayı düşünüyorsanız önce hak sahibiyle iletişime geçin.
Bir dil modeli, çıktının kurallara uyup uymadığını denetleyebilir mi?
Kısmen. Benzetme ve duygu adı gibi yüzeydeki yasaklar için otomatik tarama yararlı bir ön filtredir. Maddeleşen metafor ve atmosfer çelişkisi gibi çıkarım gerektiren teknikler için mevcut güvenilirlik verisi, dil modellerinin tek hakem olarak kullanılmasına karşı uyarıyor; bu tekniklerde insan etiketlemesi gerekir.
Türkçe ve İngilizce için aynı yöntem kullanılabilir mi?
Yöntem aynıdır, ama veri kümesinin iki dil yarısı aynı şemayı paylaşmaz. İngilizce kayıtlarda instruction alanı bulunur, Türkçe kayıtlarda bulunmaz ve fiziksel matris iki dilde farklı gösterimlerle kodlanmıştır. Güvenilirlik çalışmaları da şimdiye kadar yalnızca Türkçe sahnelerde yapılmıştır.
Kaynakça
- Bulut, L. (2026). Objective Projection Dataset: The Bulut Doctrine Narrative Engineering Corpus (v8.0). Hugging Face Datasets. https://doi.org/10.57967/hf/8960. Zenodo arşivi: https://doi.org/10.5281/zenodo.19511369
- Bulut, L. (2026). Inter-Rater Reliability of LLM and Rule-Based Annotation for Inferential Narrative Features: Three Studies on a Turkish Corpus. arXiv:2609.13936. https://doi.org/10.5281/zenodo.21740239
- Bulut, L. (2026). Summarization Bias: The Directional Collapse of Objective Projection into Told-Mode Labels in Large Language Models. arXiv:2609.20712. https://doi.org/10.5281/zenodo.22817289
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Eliot, T. S. (1920). Hamlet and his problems. The Sacred Wood: Essays on Poetry and Criticism içinde. London: Methuen. (İlk yayım: 1919.)
- Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., Wang, L., & Chen, W. (2021). LoRA: Low-rank adaptation of large language models. arXiv:2106.09685. https://arxiv.org/abs/2106.09685
- Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D., & Finn, C. (2023). Direct preference optimization: Your language model is secretly a reward model. arXiv:2305.18290. https://arxiv.org/abs/2305.18290
- Hugging Face. TRL: SFT Trainer (belgeler). https://huggingface.co/docs/trl/sft_trainer
Bu makaleye atıf
Bu yazıya atıf yapmak için aşağıdaki BibTeX kaydını kullanabilirsiniz. Yazarın diğer kayıtlı çalışmaları Levent Bulut derlem sayfasında listelenmiştir; yazar hakkında bilgi için Levent Bulut sayfasına bakabilirsiniz.
@misc{bulut2026promptsft,
  author       = {Bulut, Levent},
  title        = {Yapay Zekâya Duyguyu Göstermeyi Öğretmek: Nesnel İzdüşüm için Prompt Mühendisliği ve SFT Rehberi},
  year         = {2026},
  month        = sep,
  howpublished = {\url{https://leventbulut.com/yapay-zeka-prompt-sft-rehberi-nesnel-izdusum/}},
  note         = {Bulut Doktrini, Hesaplamalı Anlatıbilim},
  language     = {turkish}
}